太激动了,两天就睡了 12 小时。
这次单兵作战,最后排名 254。第二天的题目大多没打,比赛就这么结束了。
题目目录
| 分类 | 题目 | 主要切入点 |
|---|---|---|
| Misc | 宇宙微波背景辐射 | 容器附件、字幕、相邻帧相关性 |
| Misc | Dreambound | 奖励网络、中间激活、离散序列搜索 |
| Misc | NeuronShuffle | 随机种子复现、神经元置换 |
| Misc | 谍影重重 | 流量取证、桌面重建、备份恢复 |
| Crypto | frozen | 损坏内存、NTRU 分解树、稳健拟合 |
| Crypto | hoRRibleRing | 隐藏公因子、噪声协方差、格约化 |
| Crypto | crp-12025 | 已知部分素因子、小根与模数回验 |
| Reverse | ELFStudy | 动态重定位、IFUNC、Feistel |
| Reverse | license | 单步异常、指令解密、约束求解 |
| Reverse | Firmware | 固件密钥材料、虚拟机、SM4 |
| Reverse | vmshare | 有效密钥位数、中间相遇、等价输入 |
| Pwn | Babyv8 | JIT 类型分析与垃圾回收 |
| Pwn | Babel | 移动式 GC 与引用一致性 |
| Pwn | Babysilent | 无普通输出环境下的观测 |
| Pwn | Babystar | 协议解析差异与组合权限 |
| Pwn | Babyark | 字节码、对象布局与边界检查 |
| Pwn | CanonicoPWN | 内核环境核对与实验工程问题 |
| Pwn | oldsvr | MIPS64、协议状态与内存生命周期 |
| Web | ezphp | 服务端请求边界与会话反序列化 |
Misc
宇宙微波背景辐射
从视频容器找入口
附件解压后只有一个约 631 MB 的 MKV。直接播放,注意力很容易只落在默认视频轨上;检查容器结构后,才发现它还带着额外的视频轨、字幕轨和两个 TAR 附件。
| 载体 | 得到的数据 |
|---|---|
附件 g2.tar、g4.tar |
各 200 张按序号排列的 PNG |
| 字幕轨 | 200 段十六进制编码的 PNG |
| 额外视频轨 | 400 帧,前后各分成 200 帧 |
| 主视频结尾 | 正常内容之后的最后 200 帧雪花 |
字幕文本以 89504e470d0a1a0a 开头,正好是 PNG 文件头。先去掉空白,再按十六进制解码,就能恢复图片。额外视频轨的前后两组需要分开统计,否则恢复的文字会相互叠加。
最后收集到六组数据,每组 200 张,统一为 960×540 的灰度图。单张图看起来只有噪声:
直接平均为什么没有用
最开始尝试了对同组图片求平均,但没有出现稳定文字。真正的信号藏在同一位置的像素随时间变化的规律里。
无损 PNG 的像素主要集中在 8 和 242,先用 125 作为阈值二值化,再计算相邻帧的异或。对每个位置统计“相邻两帧不同”的比例:
B[t] = I[t] > 125
D = sum(B[t] XOR B[t-1]) / 199
独立、均衡的黑白噪声,变化比例接近 0.5。文字区域的相邻帧存在相关性,变化比例会低一些。这次求解中,几组无损 PNG 的背景约为 0.499,文字区域约为 0.43~0.46。
核心处理如下,输入是已经按顺序读取的灰度帧:
previous = None
total = None
count = 0
for frame in frames:
    current = np.asarray(frame) > 125
    if previous is not None:
        if total is None:
            total = np.zeros(current.shape, dtype=np.float64)
        total += np.logical_xor(previous, current)
        count += 1
    previous = current

probability = gaussian_filter(total / count, sigma=1)
result = np.uint8(np.clip((probability - 0.40) * 1800, 0, 255))
200 帧只有 199 组相邻帧差异。平滑和对比度增强放在统计之后,0.40 和 1800 只是显示参数,不是密钥。
恢复与拼接
六组图片分开处理后,按语义衔接得到的顺序是 1 → 2 → 5 → 4 → 3 → 6,不能直接按载体编号拼起来。
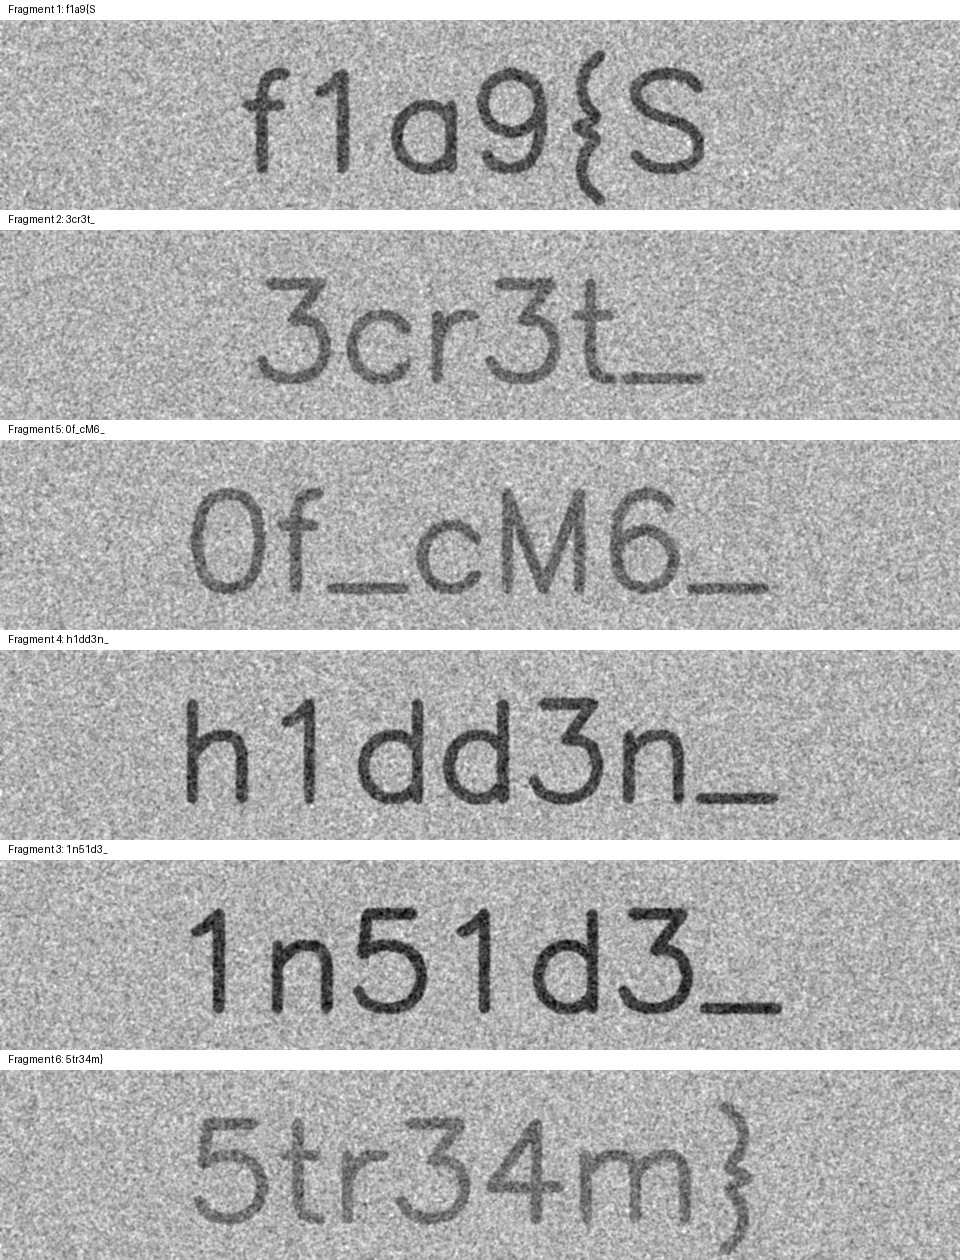
识别时要保留 leetspeak 中的数字和大小写。这题给我的提醒是:单帧没有信号,不代表整段序列没有信号;平均亮度看不出来的内容,还可以从时间相关性里找。
Dreambound
题面只有一句:Try to dream hallucinate。
附件中的 model.py、checkpoint.pt 和依赖文件,实际上给了一个可以离线评估候选动作的评分器。模型用五维 one-hot 动作驱动 GRU,再由奖励网络预测每一步的奖励。动作序列长度为 48,每个动作取 0~4。
h[0] = 0
h[t+1] = GRU(onehot(action[t]), h[t])
reward[t] = reward_head(h[t+1])
目标:最大化 48 步奖励之和
从最终奖励的平台期转向中间激活
直接替换动作、插入删除片段、CEM 和束搜索,都曾把累计奖励推到约 843.68,但继续在附近搜索时提升很有限。单独优化某一步的奖励,也出现过约 60.36 的平台。
检查奖励头后,发现最终线性层有 153 个权重大于 1 的单元。这些单元激活后可以贡献很大的正奖励,但旧序列在最后一步仍没有激活它们:相应的 ReLU 前数值全部为负。
问题在于,-20 和 -1 经过 ReLU 都变成零。只看最终奖励,搜索就分辨不出哪个候选更接近激活区域。因此,探索阶段改为优化这些单元的 ReLU 前数值。
多分支搜索与累计奖励优化
这次求解中使用 32 个分支,每个分支选择不同的目标单元;每轮采样 96 条序列,保留前 8 条,按精英样本中的动作频率更新分布。同时保留历史最优候选,并继续记录真实奖励。
找到高奖励种子后,再转回完整轨迹的累计奖励,围绕短动作片段和前后缀组合做局部优化。中间层目标负责走出平台,最终评分仍然由真正的累计奖励决定。
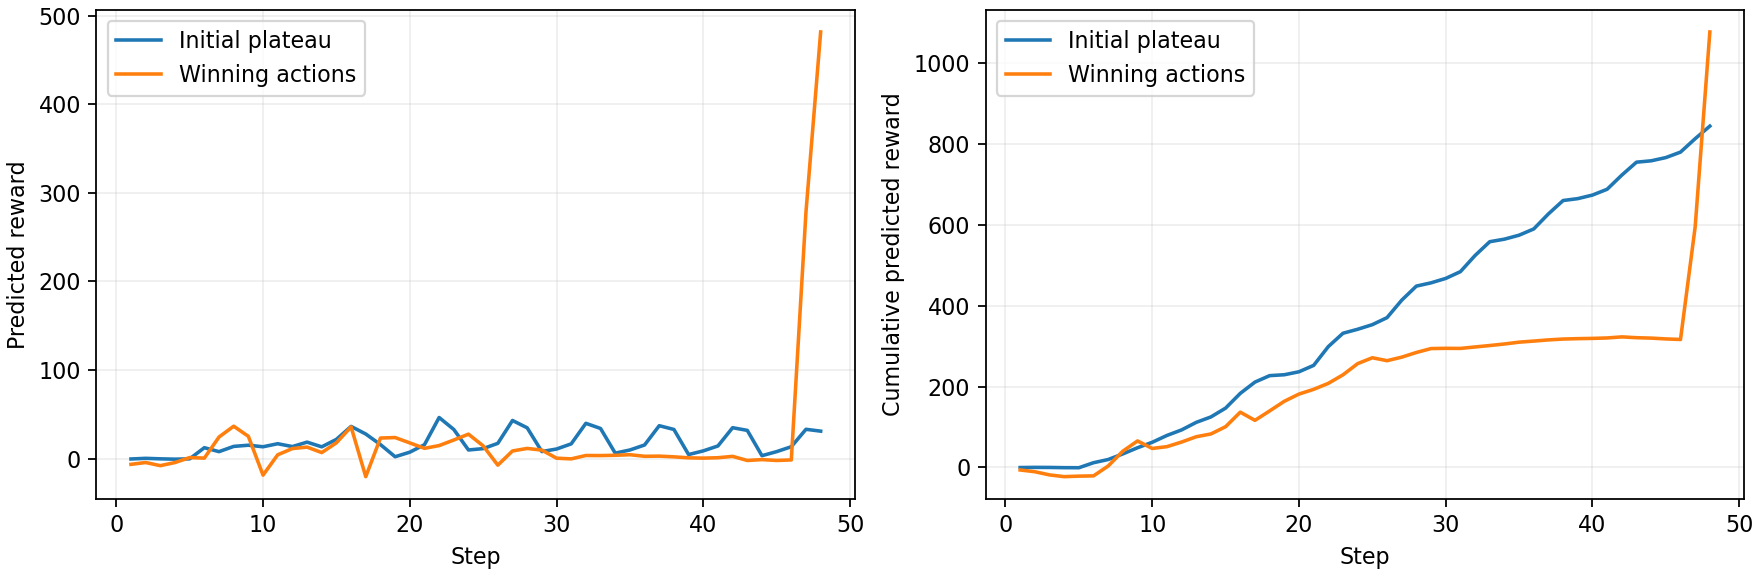
提交记录里的远端最终分数为 1076.4224,并收到了 flag。本地与远端约有 0.0017 的差异,符合记录中的浮点误差量级;这个输出只能说明该序列通过了判定,不能据此反推出精确阈值。
这题最有意思的地方,是暂时换一个更有区分度的优化目标,再回到原问题。一直盯着最终分数加搜索量,并没有带来同样的突破。
NeuronShuffle
目标是恢复三个隐藏层的神经元排列,并通过附件里的 check.py。校验接受三段排列序列,规范化表示后再计算哈希,因此可以在本地直接判断候选。
先从张量形状还原网络
model_A.npz 中的名称被替换成了 k0~k7,但形状仍保留了网络结构:
| 层 | 权重 | 权重形状 | 偏置 |
|---|---|---|---|
| 第一层 | k5 |
48×32 | k3 |
| 第二层 | k2 |
40×48 | k4 |
| 第三层 | k6 |
32×40 | k7 |
| 输出层 | k1 |
16×32 | k0 |
三个隐藏层宽度正好是 48、40、32。一层神经元重排,需要同时调整该层权重的行、偏置,以及下一层权重的列,单独比较某行不能确定全部对应关系。
原模型还有大量重复数值。例如第一层 48 个神经元只有 14 种不同的输入权重行。这使只按局部特征匹配的办法更加不可靠。
参数数值暴露了生成规律
另一个模型文件没有正常的 NPZ 文件头,常见的编码猜测没有得到有效结果,于是转而检查第一个模型的随机性。
把参数合并去重后,有 926 个不同浮点数。神经元排列会改变位置,却不会改变数值集合。以日期整数为候选种子、以正态分布为生成假设进行验证,发现这些数值能够精确出现在同一段随机抽样序列中。
这里检查的是浮点数的精确相等,而不是近似分布相似。继续核对抽样区间,能够与“先生成基础权重和偏置,再按分组扩展神经元”的方式对应起来。
用原校验器收尾
接着检查附近种子生成的三组排列,并同时验证正排列与逆排列两种索引约定。三次 permutation 调用必须共享同一个随机数生成器,不能每层重新初始化。
最终候选通过了附件中的原始校验。这个结果证明的是排列与校验常量一致,并不意味着已经还原了第二个模型的编码算法。
谍影重重
这是一条连续的离线取证链。附件包括管理侧和内部网络的 PCAP,以及浏览器 TLS 密钥日志;第三问通过后还会解锁 RDP 密钥文件。
沿数据的去向逐层恢复
整体顺序是:
管理页面流量
  → noVNC / RFB 桌面画面与输入
  → RDP 磁盘重定向中的备份文件
  → Restic 仓库及最新快照
  → MouseVault 文件
  → 资产数据库
管理流量中的 WebSocket 请求能给出 PVE 节点和虚拟机信息。继续区分客户端输入事件与服务端图像更新,恢复 Tight 编码矩形,才能把网络字节与桌面上的实际操作对应起来。
后续沿 RDP 磁盘重定向的文件传输重组备份仓库,再恢复快照。每一层恢复出来的对象,都是下一层的输入,因此要保留对应关系,不能只截一张看起来正确的图就跳到结论。
解密后还要证明文件完整
保险库处理包括派生密钥、认证检查、解密和解析内部文件记录。这次求解中先验证 HMAC,再解密并移除填充,最终恢复出 core-assets.db。
数据库的 PRAGMA integrity_check 返回 ok,并记录了以下数量:
| 内容 | 记录数 |
|---|---|
| 资产 | 256 |
| 部署 | 256 |
| 配置修订 | 512 |
| 导出清单 | 1 |
最后以文件名、字节长度和 SHA-256 组合回答题目。这里的证据不止是“能打开数据库”,还包括认证、结构完整性和最终字节摘要。
Crypto
frozen
附件包含 NTRU 公钥、发生随机位翻转的私钥展开内存和密文。直接存储私钥频谱的部分已被截掉,但后面的分解树仍然留下了约束。
先缩小真正需要恢复的量
从密钥派生往回看,解密并不需要完整恢复四个私钥多项式,只需要整数多项式:
R = Z[x] / (x^128 + 1)
D = f·adj(f) + g·adj(g)
D 的 128 个整数系数会参与密钥派生,不能擅自对它们取模,也不能改变规范化字符串中的符号或分隔方式。
按源码的序列化顺序核对内存,剩余长度是 18432 字节,也就是 2304 个 double。舍弃顶层后,两棵子树共留下 2048 个观测值。
两棵树共享同一未知频谱
把 D 的频谱记为 E,左侧树的输入是 E;利用 NTRU 关系,可以把右侧输入化简为 q²/E。因此两棵树可以同时由同一个未知量构造。
频谱为正,且满足共轭对称性。用 64 个独立的对数参数表示它,能在优化过程中直接保证正值与对称约束,而不是每轮拟合后再修补非法结果。
位翻转不能简单当成小噪声
损坏涉及尾数、部分指数位和符号位。少量严重异常值可能主导普通最小二乘,所以求解采用稳健损失,联合拟合两棵树,并逐步收紧残差尺度。
拟合结束后,逆变换回系数域、取整,再按原始派生方式检查候选明文。判断恢复是否可靠,要看整数系数和解密结果能否闭合,不能只看一个很小的浮点残差。
hoRRibleRing
这题需要区分带小噪声的环上样本与均匀随机样本。原始模多项式为 512 次,直接构造格的代价很高。
稀疏关系带来降维入口
分析从有限域根的幂次关系中找到小系数多项式 G,并验证它与模多项式 f 共享一个 58 次公因子 h。
重要的是 h = gcd(f, G),不是误把整个 G 当成 f 的因子。投影到 h 后,虽然约束减少了,但秘密和噪声的统计性质也发生了变化。
降维以后重新计算噪声
直接对 h 取余,不能假设余式仍是独立的小高斯系数。分析先在整数环中对小系数、首一的 G 取余,将两组未知量各压到 90 维,再根据各单项式余式计算真实协方差。
对白化后的两部分构造加权嵌入格,维数为:
122 + 58 + 1 = 181还要核对系数的排列和符号,再应用协方差变换。否则,形式上仍然是一个格,衡量的却已经不是原来的噪声距离。
“没找到”不等于“一定不存在”
首轮 LLL / BKZ 没找到短向量,不能立刻把该位判为随机样本。这次求解中确实存在小块大小漏检、加强约化后才找到目标的情况。
最终记录包括 117 个恢复为零的位的短向量证据,均通过精确有限域等式检查;恢复过程还使用了 flag{UUID} 的格式先验,并非对全部 336 位逐一独立盲解。手头没有平台在线回执,因此这里保留为本地求解和校验结论。
crp-12025
题目把 RSA 与改造的分组加密查询放在一起。原记录保存了同一连接下的目标密文、提示密文和 2500 组样本。
先检查提示究竟约束了什么
提示文本本身就在附件中。将其 UTF-8 字节解释为整数 H 后,位长为 351。结合题面的因子位数信息,求解确定一个 704 位素因子具有以下形式:
q = H × 2^353 + x
0 ≤ x < 2^353
于是未知部分转化为模未知素因子的单变量小根问题。分析使用 12 维整数格恢复候选,再检查候选的位长、素性以及是否真正整除完整模数。
不必强行分解全部余因子
找到这个大素因子后,这次求解中的明文只有 335 位,小于该因子。在满足指数可逆条件时,可以先在这个素数模下恢复明文,再做完整模数回验:
pow(m, 65537, N) == TARGET_CT记录中的完整模数回验通过了这个等式。这个验证比“解出来像 flag”更直接:它排除了仅在部分模数下成立的偶然候选。
分组加密部分另有独立故障分析,恢复的密钥重新加密全部 2500 组样本均匹配。但因为提示原文已经随附件提供,最终 RSA 求解不需要重新走完整的采样和分组加密分析。把必要条件与额外分析分开,整个解题过程会更清楚。
Reverse
ELFStudy
表面上是一个 ELF 信息查看器,常规字符串和 main 都在做正常的文件解析。真正的校验逻辑藏在加载过程里。
切入点是节表与动态段对重定位表长度的描述不一致。沿动态链接器的实际视角跟进,能够看到符号被调整、隐藏重定位表被复制,以及由重定位运算构造代码的过程;之后再通过 IFUNC 完成解密。
这意味着只看反编译器识别出的函数列表,会漏掉装载期间产生的实际代码。静态还原加载过程后,后续问题才变成较熟悉的输入定位和 30 轮 Feistel 变换求逆。
最后将恢复出的输入交给未经修改的附件程序,并获得隐藏校验的成功输出。这里验证的是原程序接受输入,而不是分析模型内部自洽。
license
这题在白盒查表之后设置了信号处理函数,通过 TF 单步异常运行隐藏代码。异常路径属于执行器的正常控制流,不能直接当成反调试噪声跳过去。
分析过程分成三个层次:
- 模拟执行器,记录每次解密后实际执行的指令。
- 利用输入与解密状态之间的关系,恢复隐藏 VM 程序和部分输入约束。
- 逆掉前半段的线性混合与 Feistel,再用约束求解处理剩余输入。
其中最容易混淆的是环境状态和系统调用附近的单步时机。模拟器里修正临时状态,是为了提取合法执行所需的约束;最后仍需要把恢复出的 license 直接交给原始程序验证,不能把模拟阶段的修正当成最终解法。
Firmware
附件由 fw_a、fw_b.bin 和 ota_package.bin 组成。三者分别提供白盒查表与校验信息、密钥材料生成逻辑,以及分块编码的虚拟机程序和密文。
流程可以拆成:
恢复密钥材料
  → 按块解码 OTA 中的 VM 程序
  → 校验 CRC、执行栈操作
  → 核对整体摘要
  → 结合设备标识和栈输出派生计数器
  → 用恢复的 SM4 轮密钥解密
后续块的解码依赖前一块的明文和当前栈状态,因此不能把每块单独当成互不相关的数据。RV32 的旋转、异或、加法也必须保持对应位宽,不能让宿主语言的无限精度整数改变结果。
CRC 与摘要用于核对中间恢复结果。先让每一层的检查成立,再继续下一层,比最后拿一段乱码反查所有步骤要容易定位问题。
vmshare
输入看起来是两段七位十六进制字符串,但密钥扩展开头会截断到低 24 位。此外,程序实际接受大小写,而提示文字只要求大写。输入格式展示的空间,与加密真正使用的空间并不相同。
两侧有效密钥空间各为 2^24。将加密拆成前后两段,对一侧正向计算中间状态,另一侧逆向计算并查表,再对候选检查全部 32 字节密文,可以完成中间相遇搜索。
但恢复出有效密钥,不等于恢复了唯一输入。两段被丢弃的最高位以及字母大小写,都会产生等价字符串。这次求解中,计入实际接受的大小写后,共有 1936 个字符串能够产生相同密文。
因此这里必须把结论限定为:原程序的完整密文比较证明这些输入等价;平台是否接受某个具体字符串,需要单独判定。不能从已经丢弃的信息里继续“还原”唯一原文。
Pwn
Babyv8
附件是开启指针压缩与 V8 sandbox 的 d8。分析涉及 JIT 类型推断与垃圾回收之间的不一致,以及题目修改过的入口缓存逻辑。
需要先区分两种地址范围:JavaScript 堆内的压缩引用,与进程中的原生地址并不是一回事。即使观察到堆内数据可被错误访问,也不能跳过中间的安全边界,直接当成进程级能力。
分析时重点核对循环出口的类型信息、对象移动前后的引用,以及垃圾回收扫描是否与实际存储的值一致。记录里还专门分析了对象布局和回收时机对稳定性的影响,因此最终结果不应只用一次成功运行来描述。
Babel
自定义字节码虚拟机带类型标签、堆对象和压缩式垃圾回收。对象移动后,所有存活引用都应同步更新;如果保存引用的容器被错误地归为非引用类型,内部可能留下过期偏移。
这题需要把类型变化、对象存活状态和堆压缩放到同一条时间线上理解。仅检查某个操作的局部边界,可能看不出问题;只有继续跟踪引用在回收前后指向什么,才能判断类型混淆从哪里产生。
分阶段的处理过程也说明,环境识别、引用一致性和后续状态构造应分别验证,避免前一步已经失败,后一步却继续把无效值当成正常地址使用。
Babysilent
进入沙箱后,程序不再提供普通输出。分析关注输入读取行为与连接关闭之间的关系,而不是继续寻找正常的打印结果。
这类观测先要处理固定开销和连接噪声:相同实验条件下记录基线,再讨论变量带来的差异。超限、无效响应和连接异常也应与正常结果分开,不能直接解释为某个恢复出的字节。
题目的主要收获是:输出受到限制,并不代表没有可观测行为;但观测值与目标数据之间是否存在稳定关系,必须通过校准来证明。
Babystar
这题涉及 cFS、CCSDS 和 CFDP。分析发现,地面站与卫星接收端对同一份协议数据使用了不同的长度边界。
一个解析器依据声明长度建立视图,另一个依据实际消息长度继续处理,最终就可能对“同一个文件”得出不同结果。这里还涉及表驱动应用之间的消息组合,因此不能只判断每条操作是否单独位于白名单内。
修复检查应落在以下几个位置:
- 外层实际长度与协议声明长度必须一致。
- 解码器的读取上限应来自经过验证的消息边界。
- 最终落盘对象需要在加载端重新检查,而不只相信代理端视图。
- 对能产生内部消息的表驱动功能,要检查组合后的权限效果。
Babyark
输入是 ArkTS 编译产生的 .abc 字节码,分析涉及编译产物的结构、虚拟寄存器、词法环境与对象边界。
程序接收字节码时,文件校验通过不等于运行期访问一定安全。需要分别核对格式完整性、验证器约束,以及解释或编译执行时真正使用的范围。
在跟踪 typed array、ArrayBuffer 和原生关联对象时,也要区分逻辑长度、实际分配大小与关联的数据区。已有分析记录了返回前恢复部分对象状态的处理,说明对象生命周期与后续回收同样影响实验结果。
CanonicoPWN
无附件,服务给出虚拟机串口控制台。首先核对内核、启动参数、用户权限和可用传输方式,再讨论环境与公开分析是否对应。
这里最值得留下的是工程排查过程:
- 不能仅凭题目名或版本字符串判断环境相同,要继续核对配置、符号及相关结构。
- 页表层级等架构配置会影响既有假设,环境差异不能只靠替换常量处理。
- 只有串口时,上传、完整性校验、串口回显和实例生命周期本身也会成为实验瓶颈。
- 现有记录中包含“虚拟机内取得 root 并读取题目设备”的结果;这部分没有重新运行验证。
oldsvr
附件为 MIPS64 大端程序及对应的 uClibc 运行库,实现了自己的 MQTT 消息处理。分析涉及比较函数的语义、长度转换,以及对象释放后的使用时机。
对这类题,先确认架构和端序,再恢复协议状态机,会比直接从某个内存异常开始猜测可靠。消息类型、认证状态和计数状态都会影响某条路径是否真正可达。
内存分析则要把申请大小、实际写入长度、释放时机和后续访问对应起来。手头记录引用了一个最终求解脚本,但目录没有单独提供该文件,因此这里不把它写成一份已经重新验证的完整复现包。
Web
ezphp
分析围绕 URL 请求入口、内部服务和 PHP 会话处理之间的信任关系展开。问题跨了不止一个组件,单独看某个请求返回正常,并不足以说明整个链路安全。
可以拆成三个检查层次:
- 请求边界:用户提供的 URL 最终能访问哪些协议与目标,跳转后的目的地是否仍受约束。
- 会话存储边界:内部存储是否被当成天然可信的数据源,读写权限与会话数据来源是否有明确约束。
- 反序列化边界:读取会话时是否可能把不可信内容解释成可执行对象结构。
分析时还区分了“读取不到目标内容”和“后续处理没有触发”两类结果。这个区分在分析中很有必要:没有最终输出时,要先确定失败发生在哪一层,而不是把所有异常都归为同一个原因。
赛后
254 名,第二天还有大半题没打,这次先把结果记在这里。
整理材料时,有几处比“最后输出了什么”更值得留下:雪花图要看时间相关性,奖励搜索要走出最终分数的平台,模型参数的随机生成方式可能比编码格式更容易突破;逆向题里,原程序接受输入与自写模型算出相同结果,也不是一回事。
下次打完,附件、脚本、输出和提交记录也得及时整理,不然赛后还要重新找一遍。